
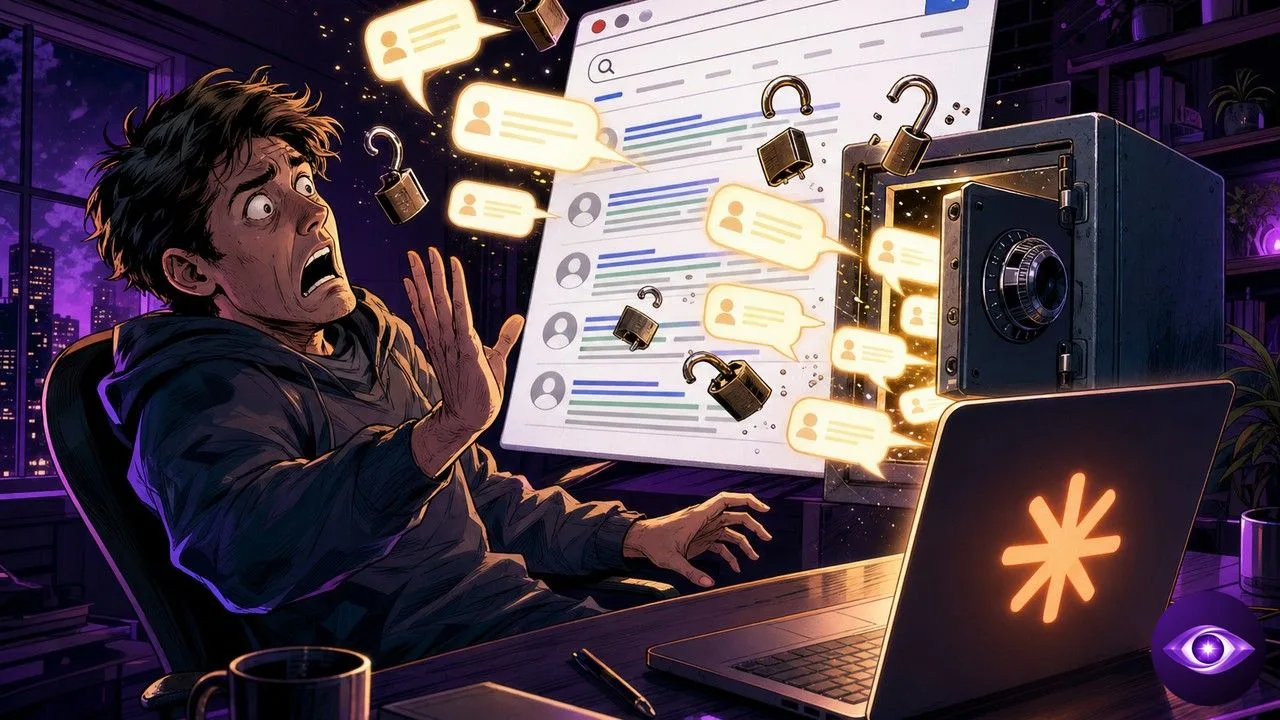
Le week-end des 25 et 26 juillet 2026, une requête a suffi pour faire remonter dans Google des conversations Claude partagées. Le cœur de l’affaire n’est pas une fuite classique, mais une erreur de configuration entre robots.txt et noindex. Un cas d’école pour tout lecteur averti.
Pour résumer
- La requête
site:claude.ai/sharea listé des conversations Claude partagées dans Google, du 25 au 27 juillet 2026. - Cause technique : le
Disallowdu robots.txt empêchait Google de lire la consigne noindex censée protéger ces pages. - OpenAI et xAI avaient déjà trébuché sur des versions de la même erreur de partage.
Un week-end de fuite via une simple requête Google
Le week-end des 25 et 26 juillet 2026, une simple requête a suffi. En tapant site:claude.ai/share dans Google, on voyait remonter une liste de conversations Claude que leurs auteurs avaient partagées via un lien. La première couverture presse est tombée le 27 juillet, relayée par Fortune, TechCrunch, The Decoder et Search Engine Journal.
La fonction en cause s’appelle « Partager via un lien ». Elle génère une page publique à l’adresse claude.ai/share/… qui contient la conversation jusqu’au point de partage. Les artefacts, ces documents et applications que Claude génère à la demande, se sont exposés de la même manière. L’outil a pourtant nourri l’essor de Claude côté grand public, comme nous l’avons documenté sur la montée en puissance de l’assistant.
Le contenu remonté n’avait rien d’anodin. Les médias citent des clés et portefeuilles crypto, des questions juridiques, des rapports médicaux avec noms de patients, des CV, des coordonnées d’enfants, des documents internes d’entreprise, des évaluations d’employés et du code niché dans les artefacts.
Pour les utilisateurs, l’impact est direct. Une donnée personnelle collée dans un fil de discussion devenait potentiellement lisible par n’importe qui via une recherche. Beaucoup pensaient partager un lien avec un collègue, pas ouvrir une page moissonnable par un moteur.
Aucun chiffre officiel n’a été publié. Les sources évoquent des « milliers » de chats, et un ordre de grandeur d’environ 600 conversations Claude a été avancé par Forbes, à prendre comme une estimation et non comme un décompte confirmé.
La fenêtre d’exposition est restée courte. Découverte les 25 et 26 juillet, elle a été corrigée côté Google dès le 27. Bing et Brave Search, eux, ont continué d’afficher certaines pages plus longtemps.
Disallow n’est pas noindex : l’erreur décortiquée
C’est ici que l’affaire devient un cas d’école. Les pages de partage étaient censées rester hors des moteurs. Elles portaient un en-tête noindex et un Disallow dans le robots.txt. Sur le papier, la protection semblait doublée.
Le problème tient à l’articulation des deux consignes. Le Disallow demande à Google de ne pas crawler la page. Mais le noindex, lui, vit dans la page elle-même. Pour le lire, Google doit justement la crawler. En bloquant le crawl, le robots.txt a rendu la consigne noindex inatteignable. Nous avions vu une tension proche autour de Claude et les données d’entreprise.
Reste à comprendre comment une page non crawlée finit indexée. Google n’a pas besoin de lire une page pour connaître son existence. Quand une URL est découverte via un lien externe, posté sur Reddit, X ou un forum, le moteur peut l’ajouter à son index sans jamais la visiter. La consigne noindex, cachée derrière le blocage, ne s’est jamais appliquée.
La leçon technique tient en une phrase que tout lecteur averti connaît déjà : Disallow n’est pas noindex. Le premier gère le crawl, le second gère l’indexation. Les confondre, c’est croire fermer une porte alors qu’on la laisse simplement absente du plan.
Les artefacts ont suivi la même logique, exposant du code et des documents générés. Nous avions déjà détaillé le fonctionnement du partage d’artefacts, dont la surface d’exposition dépasse le simple fil de discussion.
Anthropic a fini par corriger sa configuration pour rendre le noindex effectif, et Google a délisté rapidement. Un point mérite d’être souligné : délister n’est pas rendre privé. Les liens déjà exposés restent accessibles à quiconque détient l’URL, et le contenu a pu être archivé par des tiers, à la manière du Wayback Machine.
D’autres articles sur Horizon
- Open-weights : la position officielle d’Anthropic
- Hugging Face réclame les traces et 100 M$ à OpenAI
- Sakana Fugu domine les benchmarks mais reste lent
Le même piège déjà vu chez OpenAI et xAI
Anthropic n’est pas le premier à trébucher sur le partage. À l’été 2025, ChatGPT proposait une option discoverable que l’utilisateur pouvait activer. Elle a été retirée à partir du 5 août 2025 par une annonce du CISO Dane Stuckey, après que des milliers de chats aient été retrouvés dans Google. xAI et son Grok ont connu le même écueil.
Une nuance distingue le cas Claude. Chez OpenAI, l’indexation reposait sur un réglage volontaire. Chez Anthropic, elle s’est produite sans aucune option « discoverable », par un simple défaut de configuration technique. Trois acteurs, trois versions de la même erreur structurelle dans la conception des fonctions de partage. Pour la concurrence, le signal est clair : personne n’est à l’abri sur ce point.
Interrogé par la presse, Anthropic n’a pas publié de communiqué officiel. L’entreprise affirme donner aux utilisateurs le contrôle du partage, ne fournir ni répertoires ni sitemaps de chats aux moteurs, et chercher à bloquer le crawl. Elle rappelle que les liens ne sont pas devinables tant que l’utilisateur ne les diffuse pas, et que partager une conversation revient à la rendre publiquement accessible, donc archivable.
La position mérite d’être lue avec honnêteté. Le blocage robots.txt qu’Anthropic présente comme une protection est précisément ce qui a neutralisé le noindex. Et l’argument « l’utilisateur a choisi de partager » reste partiel : beaucoup n’imaginaient pas qu’un « lien partageable » pouvait glisser vers « indexé dans Google ».
Pour reprendre la main, l’utilisateur peut passer par Settings, Privacy, Shared Chats, afin de revoir ou désactiver ses partages. Un unshare coupe le lien, mais n’efface pas une URL déjà indexée ailleurs. La prudence se joue donc en amont, au moment du partage.
Reste la question de fond. Une fonction de partage IA devrait traiter l’indexation comme un choix explicite, sécurisé par défaut, et non comme un effet de bord d’une config mal alignée. Anthropic multiplie par ailleurs les déploiements de Claude jusque dans les laboratoires. La responsabilité de conception grandit à mesure que ces surfaces se répandent.
Affaire à suivre sur Horizon.


