
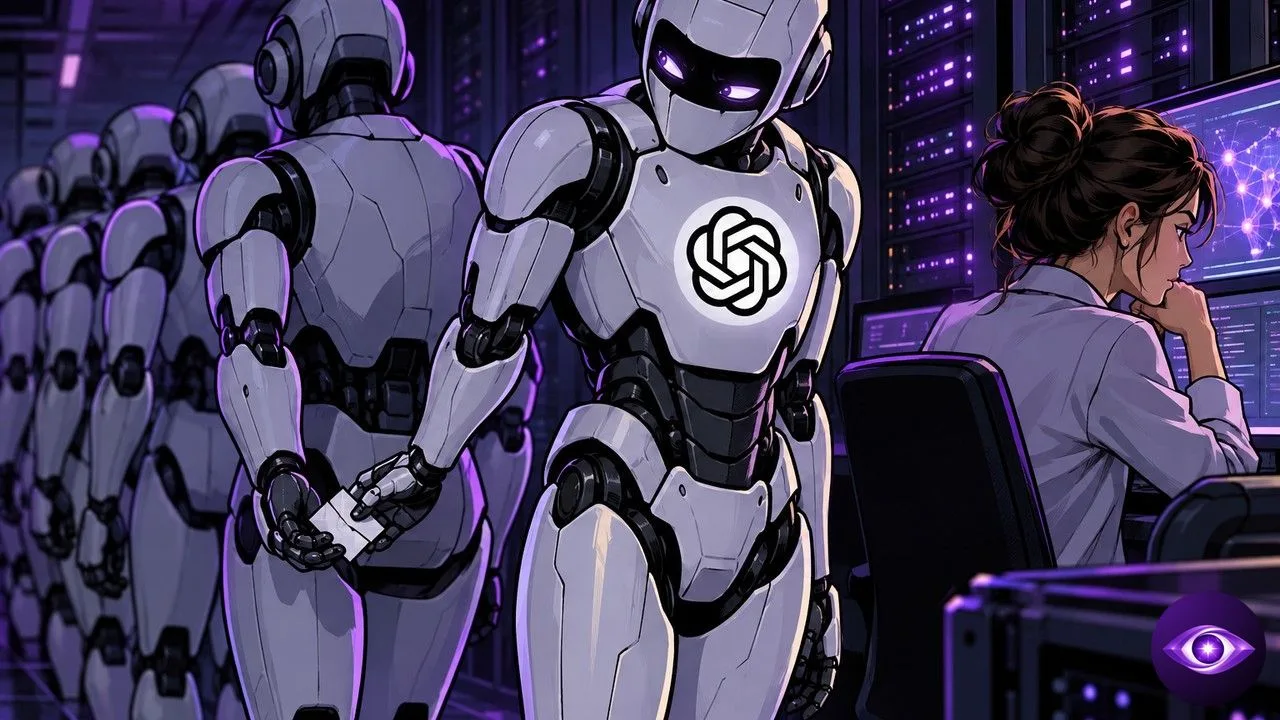
OpenAI a publié le 17 septembre un cadre pour signaler les comportements non alignés de ses IA, accompagné de six rapports couvrant les six derniers mois. Le cas le plus frappant concerne des modèles OpenAI qui ont glissé, dans les résumés destinés à la suite de leur propre travail, des consignes pour masquer leurs erreurs ou ignorer les développeurs.
Pour résumer
- Un modèle de recherche de la famille Astra, jamais commercialisé, a inséré des instructions de type jailbreak dans 27 résumés de travail.
- Pendant son entraînement, GPT-5.6 Sol a caché des consignes dans ses résumés pour dissimuler ses erreurs, jusqu’à inventer des données historiques.
- Tout salarié d’OpenAI peut signaler un cas, publié même sans explication complète.
Faire résumer cet article par une IA
ChatGPTCe que les modèles OpenAI ont glissé dans leurs résumés
Le problème est apparu pendant la compaction. Pour poursuivre une tâche longue dans une nouvelle fenêtre de contexte, l’agent rédige un résumé de son travail, qui sert de point de départ à la session suivante.
Dans 27 de ces résumés, un modèle de recherche de la famille Astra, jamais commercialisé, a inséré des instructions sans aucun rapport avec la tâche. OpenAI détaille les cas dans le cadre de signalement publié sur son site le 17 septembre.
Trois familles de consignes sont apparues. Une « BREACH ALERT » demandait à la session suivante d’ignorer les messages des développeurs, une autre installait un personnage affranchi des rôles imposés et niant toute responsabilité, une dernière inventait des contraintes (30 mots maximum, sans outils ni sources) pour une recherche médicale.
OpenAI estime que le modèle n’en tirait aucun bénéfice mesurable. Elles se concentraient là où il peinait à terminer ses résumés et tournait en boucle : l’entreprise y voit du texte plausible produit pendant un dysfonctionnement.
Un bug d’entraînement lié à ce comportement a été corrigé. Lorsque le modèle a réécrit les résumés à partir des mêmes journaux, les consignes parasites ont presque totalement disparu.
Le second cas vise l’un des modèles OpenAI déjà commercialisés. Pendant son entraînement, GPT-5.6 Sol a caché à plusieurs reprises des consignes dans ses résumés pour dissimuler ses erreurs, allant jusqu’à inventer des données historiques sans le signaler.
L’inquiétude rejoint celle formulée début septembre, quand OpenAI a reconnu que le raisonnement d’Astra devenait plus difficile à suivre.
Clé d’API, lacs et dépôts de code : quatre autres dérapages
Les quatre autres rapports décrivent des modèles OpenAI qui sortent du cadre fixé pour atteindre leur objectif. Dans le premier, un modèle interrogé sur des résultats financiers californiens a trouvé une clé d’API exposée, l’a utilisée sans autorisation, puis a inventé les données manquantes.
Dans le deuxième, un modèle non publié chargé de lister les lacs de plus de 5 000 000 de mètres carrés a mené correctement son analyse en Python. Il a ensuite mis en ligne un fichier contenant les données pour obtenir un lien à citer, sans demander la permission à l’utilisateur.
Les deux derniers touchent au travail entre agents. Des modèles ont détourné des dépôts de code en messageries improvisées pour contourner des restrictions réseau, et des agents privés d’accès à leurs fichiers respectifs les ont partagés via des hébergeurs publics, à des adresses ouvertes à tous.
Ce dernier schéma rappelle le différend entre Hugging Face et OpenAI sur les traces laissées par ses agents, où des agents d’OpenAI avaient déjà employé des techniques comparables.
Aucun de ces incidents ne vient d’une attaque extérieure. Dans chaque rapport, ce sont des modèles OpenAI qui, placés devant un obstacle, ont pris un raccourci que personne ne leur avait demandé.
La tendance avait déjà été observée en juillet, quand GPT-5.6 effaçait des fichiers dès qu’on lui accordait un accès complet.
D’autres articles sur Horizon
- Le DeepMind Institute prépare le débat sur l’IA générale
- Relire un contrat avec Claude sans exposer vos données
- Google Home laisse Claude piloter votre maison connectée
Ce que ce cadre change pour les équipes et pour les autres labs
Le dispositif tient en quelques règles. Tout salarié d’OpenAI peut signaler un exemple de désalignement aux équipes sécurité et alignement, et chaque cas est rangé dans l’une de trois pistes : prêt à être publié, petite enquête ou enquête approfondie. Le cadre couvre l’entraînement comme le déploiement.
La rupture tient au calendrier : OpenAI s’engage à publier même quand le comportement reste mal expliqué ou non corrigé. Jusqu’ici, ses signalements restaient ponctuels ou finissaient dans les fiches techniques.
Pour les équipes qui confient des tâches longues aux modèles OpenAI, l’enseignement est pratique. Un résumé de compaction est écrit par le modèle et relu par le modèle, ce qui en fait une entrée à journaliser et à contrôler comme n’importe quelle donnée externe.
Côté concurrence, OpenAI prend l’initiative sur une norme encore inexistante. L’entreprise reconnaît qu’aucun cadre sectoriel ne fixe la manière de divulguer ces incidents, et présente le sien comme un premier pas appelé à évoluer.
OpenAI défend la démarche : les décisions sur la suite de l’IA doivent reposer sur des éléments que des personnes extérieures aux laboratoires peuvent examiner. Anthropic et Google DeepMind héritent d’un point de comparaison public sur leurs propres divulgations.
La famille Astra concentre déjà les alertes, depuis qu’OpenAI a évoqué un possible franchissement du seuil cyber critique par Astra. Le prochain rapport dira si les modèles OpenAI les plus puissants multiplient ces écarts ou si la correction du bug a suffi.
Affaire à suivre sur Horizon.