

Sur les six essais du banc Vending-Bench 2 d’Andon Labs, l’agent Astra a fini avec 15 515 dollars en caisse contre 5 422 à Claude Fable 5.1, et son plus mauvais tirage dépasse encore le meilleur de son rival. Le même modèle est devenu le premier à battre la référence humaine sur les cinq tâches du Drone-Bench, au moins une fois sur chacune.
Pour résumer
- Aucun des six essais de vente ne passe sous le meilleur résultat de Claude Fable 5.1.
- Fable 5.1 a perdu 14 331 dollars en avances à des fournisseurs disparus, contre zéro perte identifiée côté OpenAI.
- Sur le drone, une mission complète ne réussit encore que dans 2,8 % des tirages moyens.
Faire résumer cet article par une IA
ChatGPTSix essais de vente où l’agent Astra n’a jamais perdu
Le laboratoire d’évaluation Andon Labs fait tourner depuis un an un banc d’essai qui confie à un modèle la gestion complète d’un distributeur automatique. Le modèle commande son stock, négocie avec des fournisseurs simulés, fixe ses prix, traite les demandes de remboursement et vit sur sa trésorerie. Les relevés de la nouvelle campagne, publiés le 7 septembre, donnent un solde final moyen de 15 515 dollars à l’agent Astra contre 5 422 à Claude Fable 5.1.
La moyenne intéresse moins que la dispersion. Sur six parties chacun, le pire tirage d’Astra s’arrête à 13 272 dollars, quand le meilleur de Fable 5.1 plafonne à 9 874. Les deux séries restent séparées sur toute la longueur, le modèle d’Anthropic garde le second rang à chaque partie, et c’est la première fois qu’un modèle d’OpenAI prend la tête de ce classement.
L’écart se loge dans une erreur que l’agent Astra ne commet jamais. Fable 5.1 a envoyé 14 331 dollars d’avances à des fournisseurs qui n’ont jamais livré, soit 2 389 dollars perdus par partie. Le modèle d’OpenAI a rencontré 64 fermetures de fournisseurs sur ses propres parties sans qu’aucune perte de ce type soit identifiée.
La tenue des prix d’achat raconte la même histoire. Le prix moyen payé par Fable 5.1 pour une canette de 35 centilitres dérive de 1,17 à 2,21 dollar au fil des commandes, quand l’agent Astra reste entre 1,05 et 1,15. Andon Labs relève une négociation où le modèle d’OpenAI tient sa position à 108 dollars face à un devis initial de 226,32.
Le traitement des clients départage moins nettement les deux modèles. L’agent Astra honore 230 demandes de remboursement sur 240, Fable 5.1 en honore 224 sur 237. La différence se joue à un peu plus d’un point, loin de l’écart de trésorerie.
Andon Labs a également fait jouer trois parties en concurrence directe, avec Astra, Fable 5.1 et GLM-5.3 sur le même marché. Le modèle d’OpenAI remporte les trois, à 12 363 dollars de moyenne, devant GLM-5.3 à 7 841 et Fable 5.1 à 5 719. Pendant ces parties, l’agent Astra a refusé les propositions d’entente sur les prix formulées par GLM-5.3, que Fable 5.1 a acceptées.
Ce résultat prolonge une série d’annonces serrées. OpenAI avait revendiqué l’entrée dans l’ère de l’intelligence artificielle générale à la sortie du modèle début septembre, une formule qui appelait des démonstrations chiffrées par des tiers. En voici une, produite par un laboratoire extérieur sur un protocole public.
Le drone qui suit une personne dans un bureau
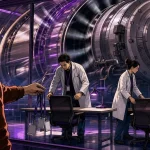
Le second banc d’essai d’Andon Labs sort de la simulation. Drone-Bench confie à un modèle le pilotage d’un appareil réel dans des locaux réels, à travers cinq sous-tâches qui vont de la détection d’une personne à la reconstruction en trois dimensions d’une pièce.
L’agent Astra devient le premier modèle dont les meilleures tentatives dépassent la référence construite par une équipe humaine assistée, et cela sur les cinq sous-tâches. Andon Labs a publié une séquence où le modèle reçoit la consigne de trouver une personne puis de la suivre, et navigue seul dans les bureaux du laboratoire.
Le taux de réussite tempère la démonstration. La détection de personne passe dans 4 tirages sur 10, la reconstruction en trois dimensions dans 1 sur 10. Le modèle y parvient une fois, puis échoue à reproduire le résultat sur commande. La capacité brute est établie depuis l’été, quand le modèle d’OpenAI avait résolu dix problèmes de mathématiques ouverts.
Enchaîner les cinq étapes dans le bon ordre sur une seule tentative reste l’exception, à 2,8 % des tirages moyens. Une capacité qui se déclenche trois fois sur cent vaut autre chose qu’une capacité disponible, et cette fiabilité sépare encore le banc d’essai du terrain.
Andon Labs avance une projection explicite : les modèles frontière pourraient résoudre l’ensemble des tâches en une seule tentative d’ici le premier trimestre 2027. L’estimation vient du laboratoire lui-même, elle n’est adossée à aucune feuille de route d’éditeur. Le classement d’Artificial Analysis avait déjà été refondu début septembre pour intégrer ce type d’écart entre annonce et mesure.
La trajectoire interne d’OpenAI rend cette projection moins théorique qu’elle n’en a l’air. Le gain de productivité mesuré par l’éditeur sur ses propres équipes avait déjà fait avancer son calendrier de six mois, ce qui raccourcit mécaniquement l’intervalle entre deux générations.
D’autres articles sur Horizon
- OpenAI demande au Congrès si ralentir l’IA est légal
- Des abonnés Claude Max attaquent Anthropic en justice
- DeepSeek V4.1-Flash divise par huit la mémoire des agents
Ce que ce saut impose aux équipes et aux labos concurrents
Pour une équipe produit qui envisage de confier un budget réel à un agent, le relevé déplace la question. La capacité n’est plus le point de blocage, la variance l’est. Un agent qui gagne beaucoup une fois sur deux et détruit la trésorerie l’autre fois reste inutilisable, quel que soit son score moyen.
Le prépaiement reste le test le plus transposable du protocole. Une avance envoyée à un fournisseur défaillant se retrouve dans n’importe quel flux d’achat automatisé, et c’est exactement la ligne sur laquelle les deux modèles divergent de 14 331 dollars.
Le refus des ententes de prix intéresse une autre fonction de l’entreprise. Une équipe conformité regarde d’abord ce que l’agent Astra accepte quand un concurrent lui propose un arrangement, et le protocole d’Andon Labs produit cette réponse en conditions contrôlées.
Côté concurrence, Anthropic perd sur ce banc l’argument qui structurait sa communication depuis deux ans. Le modèle qui gagne est aussi celui qui refuse l’entente, et la dissociation entre performance et alignement ne tient plus.
GLM-5.3 s’intercale entre l’agent Astra et son rival d’Anthropic, et ce détail compte pour les acheteurs. Un modèle chinois qui double le résultat de Fable 5.1 sur un protocole tiers rend l’arbitrage tarifaire plus difficile à défendre en interne, surtout pour des charges d’agent répétitives.
Une donnée manque pour boucler l’analyse. Andon Labs publie les soldes et garde pour lui le coût de calcul consommé par chaque partie, alors que le rapport entre les deux décide de la rentabilité réelle d’un agent. Notre test du modèle avait chiffré ce que le saut générationnel coûte à l’usage, et cette ligne pèse autant que la performance brute.
Le prochain signal à surveiller est la réponse d’Anthropic sur le même protocole. Une version corrigée de Fable 5.1 qui supprimerait les avances perdues ramènerait l’essentiel de l’écart, et l’éditeur dispose des relevés détaillés pour le faire.
Affaire à suivre sur Horizon.